Makine çevirisi nasıl çalışır: Google Translate'ten dil modellerine
Makine çevirisi, çeviri anında hiçbir insan devrede olmadan metnin bir dilden diğerine yazılımla aktarılmasıdır. Art arda dört kuşak geldi ve sonuncusunun asıl farkı daha iyi çevirmesi değil, hatalarının artık makine hatasına benzememesidir.
- Ders 2 / 6
- Başlangıç
- Ücretsiz, kayıt yok
Makine çevirisinin dört kuşağı ve her seferinde değişen şey
Sıra budur. Kesin tarihlendirme bilerek yazılmadı, çünkü kuşaklar üst üste biner ve hiçbir gün ikisinin sınırı değildir.
-
1
Kural tabanlı
Bir sözlük ve insanların elle yazdığı dilbilgisi kuralları. Öngörülebilirdi ve kimsenin öngörmediği her cümlede kırılırdı.
-
2
İstatistiksel
Büyük hacimde iki dilli metinden hangi ifadenin hangisiyle eşleştiğini öğrendi. Daha akıcıydı ve hâlâ ifade ifade çalışıyordu.
-
3
Sinir ağı
Cümlenin tamamını sayısal bir temsile çevirir ve hedef cümleyi ondan yeniden kurar. Kamuya açık makine çevirisinin şaka olmaktan çıktığı yer burasıdır.
-
4
Dil modeli
Çevirinin pek çok görevden biri olduğu ve talimat alan genel bir model: okuyucu, ton ve dokunulmayacak kelimeler.
Yeni kuşak öncekini emekliye ayırmadı. Bugün gerçek ürünlerin içinde çalışan makine çevirisinin büyük bir kısmı hâlâ sinir ağı temellidir ve yığın hâlindeki tekrarlı işler için doğru tercih olmayı sürdürür.
Son kontrol: Bu dersteki bilgiler ve araç adları bu tarihte kaynaklarıyla yeniden doğrulanır.
Makine çevirisi dört kez değişti, her seferinde ne değişti
Makine çevirisi basit bir fikirden başladı: bilgisayara bir sözlük ve dilbilgisi kuralları verin, bir cümle kurabilmeli. İlk kuşak tam olarak buydu ve kuralları insanlar elle yazıyordu. Çıktısı öngörülebilirdi ve kuralları yazanın öngörmediği her cümle onu kırıyordu.
İkinci kuşak kuralları bıraktı ve istatistiğe sığındı. Sisteme dilbilgisinin ne olduğu söylenmek yerine ona büyük hacimde iki dilli metin verildi ve hangi ifadenin genelde hangisiyle eşleştiğini kendisinin hesaplaması bırakıldı. Cümleler daha akıcı oldu ve yine de makine kokuyordu, çünkü sistem ifade ifade çalışıyor ve cümlenin tamamını hiç görmüyordu.
Üçüncü kuşak, kamuya açık makine çevirisinin şaka olmaktan çıktığı yerdir. Sinir ağı modelleri cümlenin tamamını sayısal bir temsile çevirir ve hedef cümleyi ondan yeniden üretir. Sonuç, bir insanın gülmeden okuyabileceği, yapısı doğru cümlelerdi.
Dördüncü kuşak dil modelidir ve kendinden önceki üçünden farkı derece değil tür farkıdır. İlk üçü yalnızca tek bir işi biliyordu. Dil modeli ise çevirinin pek çok görevden biri olduğu genel bir modeldir ve daha önemlisi talimat alır: ona okuyucunun kim olduğunu, tonun ne olması gerektiğini ve hangi kelimelere dokunmayacağını söyleyebilirsiniz. Önceki üç kuşağın hiçbiri bunların hiçbirini anlamıyordu.
Burada yaygın bir yanlış kanıyı düzeltmekte fayda var: bu dört kuşak birbirinin yerini almadı. Bugün gerçek ürünlerin içinde çalışan makine çevirisinin büyük bir kısmı hâlâ dil modeli değil sinir ağı temellidir ve pek çok iş için doğru tercih de odur.
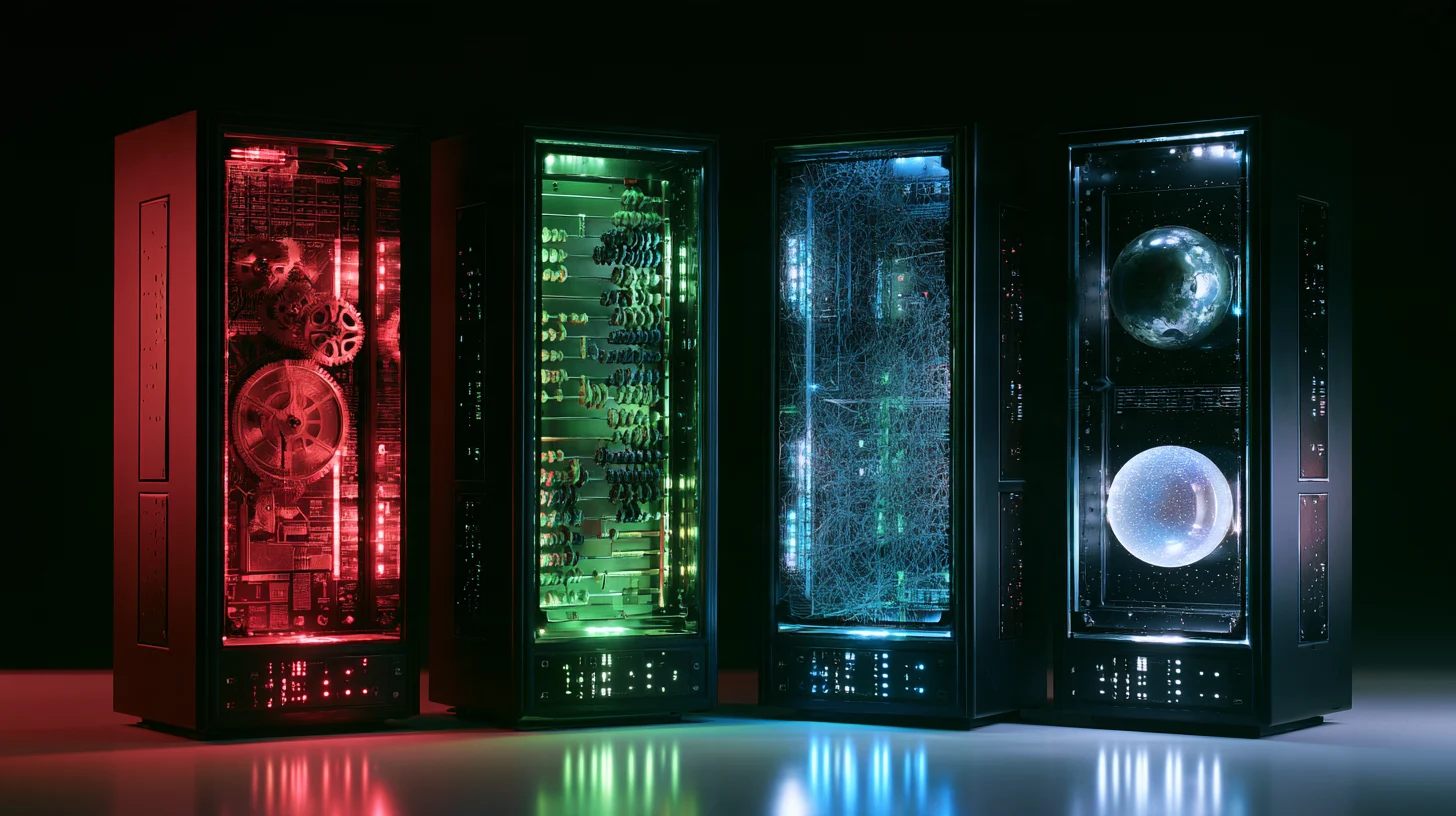
Dil modeli klasik makine çevirisini gerçekte nerede geçer
Üç yer ve üçü de tek bir şeye çıkar: dil modeli cümlenin dışını görür.
Birincisi bağlam. Belirsiz bir zamir ya da iki anlamı olan bir kelime klasik makine çevirisinde şansa bırakılır, çünkü sistemin elinde yalnızca o cümle vardır. Dil modeli paragrafın kalanını okuyabilir ve ona metnin neyle ilgili olduğunu söylerseniz tahmini tahmin olmaktan çıkar.
İkincisi ton. Klasik bir çeviri motoruna bu metnin bir müşteri için olduğunu ve resmî ama sıcak olması gerektiğini söyleyemezsiniz. Dil modeline söyleyebilirsiniz ve etkisi görünür. Bu yolun ilk dersinde gündeme gelen dil düzeyi meselesi ilk kez talimat verilebilir bir şeye dönüştü.
Üçüncüsü bir belge boyunca terim tutarlılığı. Modele bir terim listesi verirseniz, yedinci bölümün birinci bölümdeki karşılığı kullanmasını şart koşabilirsiniz. Çok dilli sitelerin her şeyden çok başarısız olduğu nokta budur.
Üçü için de önemli bir koşul geçerli: bunlar birer yetenektir, varsayılan davranış değil. Bağlam, ton ve terim listesi verilmezse dil modeli tam olarak klasik bir motor gibi davranır, yalnızca daha akıcı cümlelerle. Metni yapıştırıp düğmeye basan biri bu kuşaktan daha fazla akıcılıktan başka bir şey almaz.
İki tür hata ve hangisini görebildiğiniz
İkisi de hata yapar. Fark, hangisinin hatalarının kendini belli ettiğidir.
Klasik makine çevirisi
- Cümleler dağılır ve fiiller düşer
- Hata bir bakışta görünür
- Talimat almaz ve ton anlamaz
- Yüksek hacimde ucuz ve öngörülebilir
Dil modeli
- Cümle doğrudur ve terim uydurma olabilir
- Hata akıcıdır ve kendini gizler
- Bağlam, ton ve terim listesi alır
- O talimatlar olmadan önceki kuşak gibi davranır
Bu tablo hangisinin daha iyi çevirdiğini söylemez; hangisinin gözden geçirilmesinin daha pahalı olduğunu söyler. Yalnızca anlaşılması gereken bir metin için sağdaki sütun elimizdeki en iyisidir; imzalanan bir metin için sağdaki sütun daha az değil daha çok denetim ister.
Önceki kuşaktan nerede daha tehlikeli
Eski makine çevirisi bozulduğunda bu belli olurdu. Cümle dağılır, bir fiil düşer ve okuyucu bunu bir makinenin yazdığını ve gözden geçirilmesi gerektiğini bir bakışta görürdü. O hatalar çirkindi ve çirkinliğin kendisi bir uyarıydı.
Dil modeli o uyarıyı kaldırdı. Hataları akıcıdır. Doğru bir cümle, uygun bir ton ve ortasında o alanda kimsenin kullanmadığı bir terim. Alanı bilmeyen birinin bunu yakalamasının yolu yoktur, çünkü metinde yersiz duran hiçbir şey yoktur.
En tehlikeli biçimi terimleri kendinden emin biçimde uydurmasıdır. Model, bilmediğini söylemek yerine yapısı sağlam, kulağa profesyonel gelen ve hiçbir kaynakta bulunmayan bir karşılık üretir. Tıbbi ya da hukuki bir metinde mali ve insani zarar tam da buradan gelir. Bu davranış yapay zeka halüsinasyonu dersinde daha ayrıntılı anlatılıyor ve çeviride daha kötü bir biçim alıyor, çünkü hedef metnin okuyucusunun karşılaştıracağı bir kaynağı yoktur.
Tutumumuz açık: yalnızca anlaşılması gereken bir metin için bu kuşak şimdiye kadar sahip olduğumuz en iyi şey. Yayımlanacak ya da imzalanacak bir metin için ise bu kuşak öncekinden daha güvenli değil, daha riskli; tam da gözden geçireni uyuttuğu için.
Hangi model Farsçayı gerçekten adlandırıyor
"Çok dilli", üretici dil listesini basana kadar bir pazarlama iddiasıdır. Bu sitenin yapay zeka bölümündeki çeviri kategorisinde ölçütü bu aldık ve sonuç, hiçbiri eksiksiz olmayan iki satır.
Bir tarafta Cohere var. Command A Translate, o katalogda üreticisinin açıkça kendi makine çevirisi modeli dediği ve 23 dilini tek tek saydığı tek modeldir; bu sitenin dört dili de o listede. Diğer yüzü şu: bağlam penceresi 8.000 token, katalogdaki en kısa pencere, ve Cohere'in kendi ticari sözleşmesi İran'ı adıyla Restricted Location tanımına yazıyor. Yani Farsçayı bilen modelin İran'dan resmî bir satın alma yolu yok.
Diğer tarafta Meta var. Llama 4'ü açık ağırlıklarla ve ticari kullanıma izin veren bir lisansla veriyor; yani alıp kendi sunucunuzda çalıştırabilirsiniz. Dil listesi on iki maddelidir ve kapalıdır: Arapça var, Farsça ve Türkçe yok. Scout sürümünün penceresi ise on milyon token.
Bu tersliği aklınızda tutun, çünkü her site çeviri projesinin biçimini o belirler. Dilinizi adlandıran modelin yeri birkaç sayfa kadar, adlandırmayanınki bir kitap kadardır. Pratik sonucu şu: siteyi tek seferde değil sayfa sayfa çevirirsiniz ve uzun bir belgeyi bir kerede geçirmek istiyorsanız, çeviri için kurulmamış ve dilinizi beyan etmemiş bir modeli bilerek seçiyorsunuz demektir.
Geç kavranan bir lisans meselesi de var: açık ağırlık ile serbest kullanım aynı şey değildir. Aya Expanse gibi bir modelin ağırlıkları yayımlanmıştır ve dilleri de adlandırır, ama lisansı ticari değildir; onunla bir müşteri sitesini çevirip para alırsanız lisansı ihlal etmiş olursunuz.
Dilinizi adlandıran model ile çalıştırabildiğiniz model
Bu kategoride hiçbir zaman birlikte dolmayan iki kefe. Her iki sütun da bu sitenin yapay zeka bölümündeki kaynaklı dosyalardan geliyor.
Farsçayı adlandırıyor
- Üreticisi ona açıkça çeviri modeli diyor
- 23 dilinin hepsi tek tek sayılmış
- Penceresi 8.000 token, o katalogdaki en kısası
- Üreticinin sözleşmesi İran'ı adıyla yazıyor
Çalıştırabilirsiniz
- Ağırlıkları açık ve kendi sunucunuzda ayağa kalkar
- Dil listesi on iki maddelidir ve kapalıdır
- Farsça ve Türkçe o listede yok
- Scout sürümünün penceresi on milyon token
İki sütun da çeviri kalitesi hakkında bir şey söylemez. Üreticinin neyi beyan ettiğini ve lisansın neye izin verdiğini söylerler; çıktıyı okumak burada yapılmamış başka bir iştir.
Bütün bunlar çok dilli bir site için ne anlama geliyor
Üç pratik sonuç ve hiçbirinin en iyi modeli seçmekle ilgisi yok.
Birincisi: iş biriminiz site değil sayfadır. Özel çeviri modellerinin kısa penceresi bunu dayatır ve tesadüfen gözden geçirme için de daha iyidir, çünkü bir sayfadaki hata o sayfada bulunur. İkincisi: terim listesi ilk sayfadan önce yazılmalı ve her çağrıda metinle birlikte gitmelidir; yoksa ikinci bölümde anlatılan tutarlılık hiç gerçekleşmez. Üçüncüsü: insan denetimi her sayfaya eşit yayılmak yerine bir kararın ya da bir ödemenin geçtiği sayfalarda yoğunlaşır.
Ve nadiren yazıya dökülen dürüst bir tespit. O kategoride incelediğimiz üreticilerin hiçbiri kendi modelinin çeviri kalitesi için atıf yapılabilir bir sayı yayımlamıyor. Cohere, Command A Translate'in kendi ileri düzey çeviri modeli olduğunu yazıyor ve hiçbir puan basmıyor; diğerleri de basmıyor. Dolayısıyla en iyi çeviri yapay zekasını sıraladığını iddia eden Farsça bir tablo ya dışarıdan bir ölçüt kullanıyordur, ki hangisi olduğunu söylemesi gerekir, ya da sayılarını uyduruyordur.
Aynı şeyi kendimiz için de söylüyoruz: o kategori size hangi üreticinin o model için dilinizi listelediğini söyler, çevirisinin ne kadar doğal okunduğunu değil. İkincisini bilmek çıktıyı okumak demektir ve bu, yaptığımızı iddia etmediğimiz başka bir iştir.
Yapay zekayla hızlı yol
Herkesin varsayımı, dil modelinin klasik motoru her zaman geçtiğidir ve bazı metinler için bu varsayım yanlıştır. Basit ve tekrarlı metinde iki kuşak arasındaki fark neredeyse sıfıra iner ve hiçbir şey için para ödüyorsunuzdur; geriye göndermeler ve uzmanlık terimleriyle dolu metinde ise aynı fark işin tamamıdır. Hangi durumda olduğunuzu her metin türü için bir kez öğrenmek yirmi dakika alır ve ondan sonra tahmin etmeniz gerekmez.
- O metin türünden temsili bir paragraf alın ve en kolayını seçmeyin. En az bir tanesi geride kalan bir göndergeye sahip zamir ve bir uzmanlık terimi içeren bir paragraf alın; çünkü iki kuşak arasındaki fark yalnızca orada görünür.
- İlk geçişi hiçbir şey eklemeden çalıştırın: yalnızca paragraf ve bunu hedef dile çevir diyen tek bir satır. Bu, güncel bir modelle benzetilmiş klasik kuşaktır.
- İkinci geçişi aynı modelle ve aynı paragrafla çalıştırın, ama bu kez ilk dersteki dört şeyi üstüne koyun: okuyucu kim, metin ne yapmalı, dil düzeyi nerede duruyor ve hangi kelimeler çevrilmiyor.
- İki çıktıyı yeni bir çağrıda modele verin ve aşağıdaki tarifi çalıştırın. Bunun için yeni bir konuşma açın; onları ürettiği yerde karşılaştırmasını istemek, kendi işine hüküm vermesi demektir.
- Şimdi yalnızca kategorileri okuyun. Bütün farklar biçem ve dil düzeyine düştüyse bu metin türü bağlam brifingine ihtiyaç duymaz ve ucuza, toplu hâlde çevrilebilir. Bir tanesi bile terim ya da gönderge kategorisine düştüyse bu metin türü bağlama duyarlıdır ve her partisi o brifingle birlikte gitmelidir.
Kopyalamaya hazır şablon
Tek bir kaynak metnin iki çevirisi elinde.

Kaynak metin:
{kaynak metin}

Çeviri A:
{birinci geçişin çıktısı}

Çeviri B:
{ikinci geçişin çıktısı}

Yalnızca farkları listele ve her farkı şu dört kategoriden birine koy:

1) Biçem: bir kelime ya da yapı değişti, anlam aynı kaldı.
2) Dil düzeyi: resmiyet derecesi değişti.
3) Terim: bir uzmanlık teriminin karşılığı değişti.
4) Gönderge: bir zamir ya da işaret artık başka bir şeye gönderiyor.

Her madde için iki biçimi de birebir alıntıla. Hiçbirine daha iyi ya da daha kötü deme ve üçüncü bir biçim önerme. Bir kategori boşsa boş bırak.
Çıktıya güvenmeden önce: Bu bir teşhistir, hüküm değil. Üçüncü ve dördüncü kategoriler modelin en kötü işini yaptığı yerdir; bu yüzden oraya koyduğu her maddeyi o alandaki gerçek bir kaynakla kendiniz denetleyin ve sınıflandırmasına güvenmeyin. Ve bir paragraf bir örnektir: en zor paragrafınızda iki geçiş aynı çıktıysa bu, o metin türü hakkında bir tespittir; çevirdiğiniz her şeyi kapsayan bir izin değil.
Bu işte yapay zeka
Bu konuda işe yarayan soru hangisinin daha iyi olduğu değildir. İşe yarayan soru şudur: üretici o modele özel olarak dilinizi adıyla yazdı mı ve ona hiç ulaşabiliyor musunuz. Bu sitenin yapay zeka bölümünde bu kategorinin adaylarına tam olarak bu iki ölçütü uyguladık ve iki koşulu birden karşılamayan iki satır çıktı. Aşağıdaki her araç bir kalite iddiasıyla değil, bu iki soruyla tanıtılıyor.
Gerçekten işe yarayan araçlar
- Cohere Kendi belgeleri Command A Translate'i makine çevirisi modeli olarak sunuyor ve 23 dilini listeliyor; Farsça, Arapça, Türkçe ve İngilizce bunların arasında. Penceresi 8.000 token ve kendi ticari sözleşmesi İran'ı adıyla Restricted Location tanımına yazıyor.
- Llama 4 Scout Açık ağırlıklar ve ticari kullanıma izin veren bir lisans; aylık 700 milyon kullanıcı tavanı ve Llama adını gösterme zorunluluğuyla. Dil listesi kapalı ve on iki maddeli, içinde Farsça ve Türkçe yok; penceresi ise on milyon token.
- Mistral Large 3 Bu kategorideki en özgür lisansı taşıyor: açık ağırlıklarla ve tam ticari kullanımla Apache 2.0. Buna rağmen Mistral bu model için ne eksiksiz bir dil listesi ne de bir ülke listesi yayımlıyor; tablomuzda sıra alamamasının sebebi bu. Kanıtın yokluğu başlı başına bir cevaptır.
- Gemini Yukarıdaki teşhis geçişi için uygundur, çünkü Farsçayı kendisi okur ve metnin önce İngilizceden geçmesi gerekmez. Google'ın kendi sayfası uygulamanın 230'dan fazla ülke ve bölgede, 70'ten fazla dilde çalıştığını söylüyor ve İran o listede yok.
Nerede geri teper
Üç risk ve birincisi bu dersin tamamının konusu: akıcı hata. Bir dil modeli doğru karşılığı bilmediğinde, bilmediğini söylemek yerine yapısı sağlam ve kulağa profesyonel gelen bir karşılık üretir. Onu işaretleyen hiçbir şey yoktur. Tek savunma, çıktının alanı bilen biri tarafından okunmasıdır ve makine çevirisini bedava değil ucuz kılan da budur. İkinci risk dil listeleridir: "çok dilli", üretici listeyi basana kadar bir pazarlama iddiasıdır ve bir model ailesinin listesi belirli bir sürümün listesi değildir. Üçüncüsü site sahipleri içindir: makine çevirisi metni insan denetimi olmadan toplu hâlde yayımlamak, Google'ın spam politikalarının ölçekli içerik istismarı diye tanımladığı örüntünün ta kendisidir. Mesele dil ya da araç değil; kimsenin okumadığı bir şeyi yayımlamaktır.
Kaynaklar: Cohere: models, with the Command A Translate language list and context window Cohere: commercial SaaS agreement (Restricted Locations) Meta: Llama 4 Scout model card Meta: Llama 4 licence Google: where Gemini Apps are available Google Search Central: spam policies for Google web search
Bu tavsiyenin sınırı
Bu ders bu modellerin çeviri kalitesi hakkında bir şey söylemez ve söylememelidir. Üreticilerin yayımladığı listeleri okuduk ve onlara atıf yaptık; her birinin Farsçasının ne kadar doğal okunduğu çıktıyı okumayı gerektirir ve bu burada yapılmadı. İki sınır daha var. Kuşaklar bilerek yılsız yazıldı, çünkü üst üste binerler ve kesin bir tarihlendirme arkasında duramayacağımız bir iddiadır. Dil listeleri, lisanslar ve erişim ise üreticinin yarın değiştirebileceği şeylerdir; bu sayfanın üstündeki doğrulama tarihi, üzerindeki her sayının geçerlilik sınırıdır. Pratik iş akışı, yani bu araçlarla bir belgeyi gerçekte nasıl çevirip düzelttiğiniz, bu yolun bir sonraki dersinin konusu; burada yalnızca teşhis kondu.
Kendi işimizden
Bu sitenin yapay zeka bölümündeki çeviri kategorisini kurarken tablonun ilk sütunu bir çeviri kalite puanı olacaktı. O sütun hiç kurulmadı, çünkü yedi adaydan bir tanesi bile kendi modelinin çeviri kalitesi için bir sayı yayımlamamıştı; Cohere, Command A Translate'in kendi ileri düzey çeviri modeli olduğunu yazıyor ve hiçbir puan basmıyor, diğerleri de basmıyor. Hiçbir aday için rakamı olmayan bir sütun, sütun değildir. Bir sütun daha denendi ve geri çekildi: bağlam penceresi. Sıralama motoru her sayısal sütunu en düşük ve en yüksek aday arasında normalleştiriyor ve burada en düşük 8.000 token, en yüksek on milyondu; üç büyüklük mertebesi fark. Sonuç, gerçekte otuz iki kat olan bir farkın tabloda 0,4'e karşı 0,2 olarak görünmesiydi. Sayı tablodan çıktı, savı metinde kaldı. Bu iki karar çevirinin ötesine geçen bir ders taşıyor: sütununun arkasında kanıt olmayan bir tablonun yalnızca tablo biçimi vardır.
Gerçek devam soruları
Google Translate mi daha iyi, yoksa bir dil modeliyle çeviri mi?
Ne yaptığınıza bağlı. Bir metni hızlıca anlamak ya da yüksek ve tekrarlı hacim için özel bir çeviri motoru daha ucuz ve daha öngörülebilirdir. Tonu, bağlamı ve tutarlı kalması gereken terimleri olan bir metin için dil modeli öne geçer, ama yalnızca o bağlamı ona verirseniz; brifing olmadan ikisi arasındaki fark cümlelerin akıcılığına iner.
Bir modelin dilimi gerçekten desteklediğini nasıl anlarım?
O belirli sürümün dil listesini bir makalede ya da model ailesi için değil, üreticinin kendi belgelerinde bulun. Üretici bir liste vermiyor ve yalnızca çok dilli diyorsa cevap bilinmiyordur ve öyle yazılmalıdır. Bir tuzak da var: "dahil olmak üzere" ile açık bırakılmış bir liste, kapalı bir listeyle aynı şey değildir ve yalnızca ikincisine atıf yapılabilir.
Makine çevirisi metin yayımlamak SEO sorunu yaratır mı?
Sorun makine çevirisinin kendisi değil, kimsenin okumadığı bir şeyi toplu hâlde yayımlamaktır. Google'ın spam politikaları bu örüntüyü ölçekli içerik istismarı diye tanımlar ve aynı sayfada ölçütün üretim aracı değil, faydasızlık ve ölçek olduğu okunur. Yani bir insanın gözden geçirdiği ve o dilin okuyucusu için yerine oturttuğu tek bir çevrilmiş sayfada sorun yoktur; motordan doğruca siteye giden iki yüz sayfada vardır.