مدل های متن باز؛ کیمی و دیپ سیک و کوئن
مدل متن باز یعنی وزن های مدل به شکل چند فایل قابل دانلود منتشر شده اند و می شود همان فایل ها را روی سخت افزار خودتان اجرا کرد. متن باز بودن خاصیت یک مخزن است و نه خاصیت یک شرکت: در همین کاتالوگ زد.ای، جیالام ۵.۲ با مجوز MIT نشسته و جیالام ۵.۳ با یک مجوز اختصاصی که خود شرکت نوشته.
- درس ۸ از ۱۵
- میانی
- رایگان، بدون ثبت نام
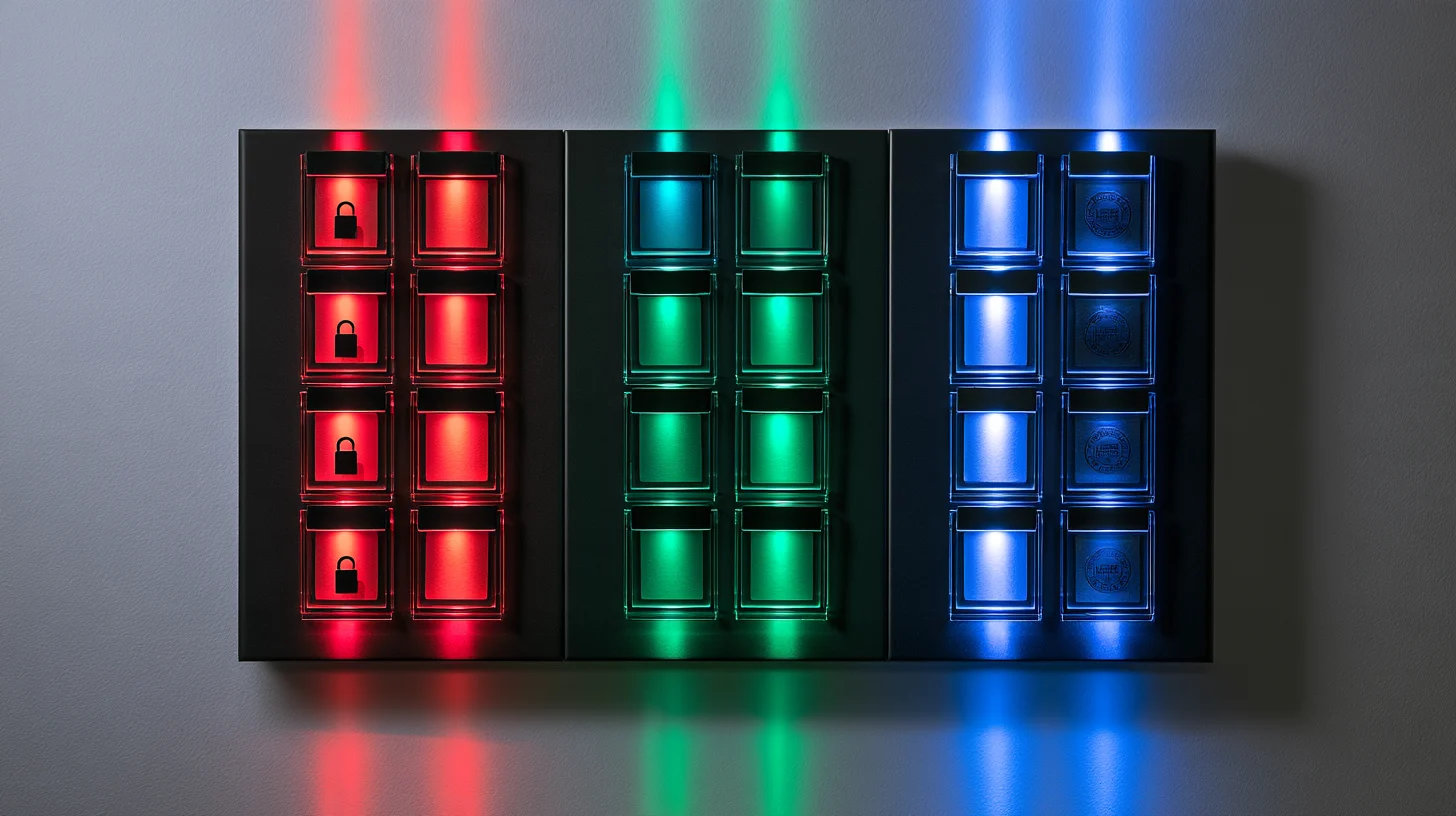
چهار سازنده، و مجوزی که هر مخزنشان امروز دارد
ستون ها سازنده اند و کارت ها مخزن. توجه کنید که در دو ستون، دو مخزن از یک شرکت دو مجوز متفاوت دارند.
-
مونشات
۱- Kimi-K3
مجوز اختصاصی kimi-k3، با شرط بیست میلیون دلار
- Kimi-K3
-
دیپ سیک
۱- DeepSeek-V4-Pro-0813
مجوز MIT، بدون هیچ شرط درآمدی
- DeepSeek-V4-Pro-0813
-
علی بابا (کوئن)
۲- Qwen3.8-27B
Apache 2.0، بدون شرط
- Qwen3.8-2.4T-A95B
مجوز اختصاصی، با شرط پنجاه میلیون دلار
- Qwen3.8-27B
-
زد.ای (جیالام)
۲- GLM-5.2
مجوز MIT
- GLM-5.3
مجوز اختصاصی، با شرط ده میلیارد دلار
- GLM-5.2
این وضعیت ۶ سپتامبر ۲۰۲۶ است و پایدار نیست. مجوز یک مخزن با انتشار نسخه بعد عوض می شود و همین فهرست چند هفته دیگر باید دوباره خوانده شود.
آخرین بررسی: فکت ها و نام ابزارهای این درس در همین تاریخ با منابعشان بازبینی شده اند.
وقتی درباره یک مدل می گوییم متن باز، دقیقا چه چیزی باز است
سه چیز کاملا متفاوت در فارسی «متن باز» نامیده می شوند و تا از هم جدا نشوند بقیه این صفحه معنا ندارد. اول وزن باز: عددهای آموخته مدل به شکل چند ده فایل قابل دانلود منتشر شده اند و شما می توانید همان فایل ها را روی سخت افزار خودتان بار کنید. دوم متن باز به معنای نرم افزاری اش، یعنی کد آموزش و داده آموزش هم منتشر باشد و مجوز هم یکی از مجوزهای شناخته شده مثل Apache 2.0 یا MIT باشد. سوم چیزی که اصلا باز نیست ولی مدام با این دو اشتباه گرفته می شود: مدلی که فقط از راه API فروخته می شود و قیمتش پایین است.
تقریبا همه مدل هایی که در این درس نام می بریم فقط در دسته اول اند. وزن ها هست، داده آموزش نیست، و در چند مورد مجوز هم اصلا یک مجوز استاندارد نیست بلکه متنی است که خود سازنده نوشته و اسمش را روی نام مدل خودش گذاشته. فاصله بین «می توانم دانلودش کنم» و «می توانم هر کاری با آن بکنم» دقیقا همان جایی است که یک پروژه تجاری گیر می کند، معمولا وقتی که کار تمام شده است.
موضع ما این است: بپرسید «این مخزن، امروز، با چه مجوزی» و نه «این شرکت متن باز است یا نه». سوال دوم جواب ندارد. یک سازنده می تواند مدل کوچکش را با Apache 2.0 بدهد و مدل پرچمدارش را با یک مجوز شرطی، و دقیقا همین کار را هم می کند.
کدام مدل ها را واقعا می شود دانلود کرد
جدول زیر را در ۱۵ شهریور ۱۴۰۵ برابر با ۶ سپتامبر ۲۰۲۶ مستقیم از مخزن خود سازنده روی هاگینگ فیس خواندیم. ستون مجوز همان چیزی است که در کارت مدل ثبت شده، نه چیزی که در خبرها نوشته شده.
| مخزن | مجوز ثبت شده | تعداد پارامتر |
|---|---|---|
| Qwen/Qwen3.8-27B | Apache 2.0 | ۲۷.۸ میلیارد |
| zai-org/GLM-5.2 | MIT | ۷۵۳ میلیارد |
| zai-org/GLM-5.3 | مجوز اختصاصی glm-5.3 | ۷۵۳ میلیارد |
| deepseek-ai/DeepSeek-V4-Pro-0813 | MIT | ۱.۶۵ تریلیون |
| moonshotai/Kimi-K3 | مجوز اختصاصی kimi-k3 | ۲.۷۸ تریلیون |
| Qwen/Qwen3.8-2.4T-A95B | مجوز اختصاصی qwen3.8-max | ۲.۴۵ تریلیون |
| meta-llama/Llama-4-Scout-17B-16E-Instruct | مجوز جامعه لاما ۴ | ۱۰۸.۶ میلیارد |
| mistralai/Mistral-Large-3-675B-Instruct-2512 | Apache 2.0 | ثبت نشده |
دو چیز در این جدول دیدنی است. اول اینکه دو ردیف اول و دوم از یک شرکت اند و مجوزشان یکی نیست؛ همین را در ستون کوئن هم می بینید، جایی که مدل ۲۷ میلیاردی Apache 2.0 است و مدل پرچمدار نیست. دوم اینکه بزرگ ترین مدل های این فهرست همان هایی هستند که مجوز شرطی دارند. این تصادف نیست: شرط ها را برای همان مدلی می نویسند که ارزش تجاری اش بیشتر است.
یک نکته درباره اسم ها که در فهرست های فارسی مدام جا می افتد: نامی که در لیدربورد می بینید همیشه نام مدل نیست. «کیمی کی۳ مکس» و «جیالام ۵.۲ مکس» در مستندات سازنده مدل جدا نیستند و max سطح تلاش استدلال است. برای همین دنبال مخزن بگردید و نه دنبال اسمی که در جدول رتبه بندی نوشته شده.
مجوز را چطور بخوانیم؛ سه شرطی که شبیه هم اند
سه مجوز اختصاصی این فهرست را کنار هم گذاشتیم و متن هر سه را خواندیم. ساختارشان تقریبا یکی است: اول یک اجازه بسیار باز به سبک MIT، بعد دو شرط که فقط از یک آستانه درآمدی به بالا فعال می شوند، و در آخر تصریح اینکه استفاده داخلی از این شرط ها معاف است.
در مجوز کیمی کی۳ شرط اول این است: اگر کسب و کار شما «مدل به عنوان سرویس» باشد، یعنی به شخص ثالثی اجازه بدهید روی ورودی و پارامترها کنترل معنادار داشته باشد، و درآمد مجموع شما در هر دوازده ماه پیوسته از بیست میلیون دلار بگذرد، باید پیش از هر استفاده تجاری با مونشات قرارداد جدا ببندید. شرط دوم می گوید محصولی که بیش از صد میلیون کاربر فعال ماهانه یا بیش از بیست میلیون دلار درآمد ماهانه دارد باید نام Kimi K3 را روی رابط کاربری اش نشان بدهد. بند چهارم هم صریح می گوید هیچ کدام از این دو به استفاده داخلی مربوط نیست.
مجوز جیالام ۵.۳ همان قالب را دارد با یک آستانه بسیار بالاتر: ده میلیارد دلار درآمد در دوازده ماه، و به جای قرارداد، عبور از یک بازبینی امنیتی زد.ای. مجوز کوئن ۳.۸ مکس آستانه پنجاه میلیون دلار می گذارد و یک دسته دوم هم اضافه می کند به نام «دستیار کاری هوش مصنوعی»، یعنی محصول مستقلی که اساسا برای کدنویسی یا کار اداری ساخته شده باشد.
حالا نتیجه عملی، و اینجا جایی است که بیشتر متن های فارسی یا می ترسانند یا ساده سازی می کنند. برای یک شرکت ایرانی با چند ده کارمند، هر سه آستانه بالا بی ربط اند. اگر شما مدل را روی سرور خودتان اجرا کنید تا کار خودتان یا کار مشتری تان را انجام بدهید، عملا با یک مجوز شبیه MIT طرف اید. مجوزی که واقعا گاز می گیرد جای دیگری است: CC BY-NC. آن یکی استفاده تجاری را در هر اندازه ای ممنوع می کند و روی مدل هایی نشسته که کسی انتظارش را ندارد، مثل مدل ترجمه چندزبانه آیا اکسپنس ۳۲بی از کوهیر. اگر آن را داخل یک پروژه مشتری بگذارید، اندازه شرکتتان اهمیتی ندارد.
کارت مدل را قبل از ساختن روی آن بخوانید
کارت مدل همان صفحه اول مخزن است و پنج چیز در آن هست که در پانزده دقیقه خوانده می شوند و بعدا چند هفته کار را نجات می دهند. اول فایل LICENSE خود مخزن، نه برچسبی که بالای صفحه نشسته. برچسب برای سه مدل این فهرست فقط other است و متن واقعی داخل فایل است. دوم اینکه اصلا فایل وزن هست یا نه: مخزنی که فایل safetensors ندارد یک صفحه توضیح است و نه یک مدل قابل اجرا.
سوم تعداد پارامتر، که تعیین می کند این مدل روی چه چیزی بالا می آید و در بخش بعد به آن می رسیم. چهارم اینکه نسخه base است یا instruct: نسخه پایه دستور نمی گیرد و اگر انتظار جواب یک چت بات را از آن داشته باشید فکر می کنید مدل خراب است. پنجم تاریخ آخرین تغییر مخزن، چون همان طور که در جدول بالا دیدید مجوز بین دو نسخه عوض می شود.
و یک تله که مخصوص کارهای واقعی است: بازنشرهای فشرده شده. جامعه معمولا نسخه های چهار بیتی و هشت بیتی مدل ها را در مخزن های خودش می گذارد و همان ها هستند که روی سخت افزار معمولی جا می شوند. آن مخزن ها همیشه مجوز مخزن اصلی را ندارند و بعضی هایشان اصلا مجوزی ثبت نکرده اند. اگر روی یکی از آنها بسازید، چیزی که تحویل مشتری می دهید مجوزش نامعلوم است. راهنمای خود هاگینگ فیس درباره مجوز مخزن ها می گوید مجوز روی هر مخزن جدا اعلام می شود، و همین یک جمله کل ماجراست.
پنج چیزی که باید خوانده شود و سه چیزی که نباید باور شود
در خود مخزن بخوانید
- فایل LICENSE، کامل، نه فقط برچسب بالای صفحه
- وجود فایل های safetensors، وگرنه مدلی برای اجرا نیست
- تعداد پارامتر، برای اینکه بدانید روی چه سخت افزاری بالا می آید
- base است یا instruct، چون رفتارشان یکی نیست
- تاریخ آخرین تغییر، چون مجوز بین دو نسخه عوض می شود
به این سه اعتماد نکنید
- خبری که می گوید فلان شرکت متن باز است
- جواب یک چت بات درباره مجوز یک مخزن مشخص
- مخزن فشرده شده ای که مجوزش را ثبت نکرده
این فهرست فقط مجوز و قابل اجرا بودن را پوشش می دهد. کیفیت مدل روی کار شما را هیچ کارت مدلی جواب نمی دهد و باید خودتان روی نمونه های واقعی خودتان بسنجید.
وزن باز یعنی فهرست کشور دیگر معنا ندارد
این یک واقعیت معماری است و نه یک راه دور زدن. یک API حساب کاربری دارد، حساب کاربری کشور دارد، کشور در فهرست کشورهای پشتیبانی شده هست یا نیست، و پرداخت هم کارت می خواهد. یک فایل وزن هیچ کدام از اینها را ندارد: چند فایل است که روی ماشینی که خودتان انتخاب کرده اید بار می شود. برای همین سوال «آیا این مدل از ایران کار می کند» درباره وزن باز اصلا سوال درستی نیست. سوال درست این است که آن ماشین کجاست و چقدر حافظه دارد.
ما در این سایت راه دور زدن محدودیت نمی نویسیم و اکانت هم نمی فروشیم؛ همان چیزی که در صفحه هوش مصنوعی از ایران نوشته ایم. آنچه اینجا می گوییم فقط این است که وزن باز یک لایه دسترسی دیگر است، نه یک ترفند. و دو محدودیت صادقانه اش را هم می گوییم: برای دانلود کردن باید به مخزن برسید، و برای اجرا باید سخت افزار داشته باشید.
سخت افزار همان جایی است که بیشتر بحث های خوش بینانه تمام می شود. یک قاعده سرانگشتی که خودتان می توانید حساب کنید: در دقت ۱۶ بیتی هر پارامتر دو بایت جا می گیرد. برای مدل ۲۷.۸ میلیارد پارامتری کوئن یعنی حدود ۵۵ گیگابایت فقط برای وزن ها، پیش از هر چیز دیگری. برای جیالام ۵.۳ با ۷۵۳ میلیارد پارامتر یعنی حدود یک و نیم ترابایت. نسخه های فشرده شده جامعه این عدد را چند برابر کم می کنند و همان ها هستند که اجرای محلی را ممکن می کنند، ولی ما هیچ کدام را روی سخت افزار خودمان اجرا نکرده ایم و عددی از خودمان نمی گوییم.
پس نتیجه صادقانه این است: مدل های کوچک این خانواده ها روی یک سرور اجاره ای معمولی قابل اجرا هستند، و مدل های پرچمدار همان فهرست نیستند. کسی که می گوید دیپ سیک متن باز است پس می توانید رایگان اجرایش کنید، احتمالا هیچ وقت ۱.۶۵ تریلیون پارامتر را جایی بار نکرده.
برای کار واقعی کدام را برداریم
سه حالت هست و جواب هر کدام فرق می کند. اگر فقط می خواهید ارزان تر از یک مدل درجه یک جواب بگیرید و اجرای محلی برایتان موضوع نیست، وزن باز اصلا به دردتان نمی خورد: همین مدل ها را از API خودشان بخرید و به عدد مقایسه ای نگاه کنید. اگر داده ای دارید که نباید از سرور شما بیرون برود، آن وقت وزن باز تنها مسیر است و باید از مدل کوچک شروع کنید و نه از پرچمدار. و اگر می خواهید مدل را داخل محصولی بگذارید که به مشتری می فروشید، اول مجوز را بخوانید و بعد کد بزنید.
ما اینجا نمی گوییم کدام مدل بهتر است، چون آن جواب هفته به هفته عوض می شود و جایش این صفحه نیست. جایش بخش مرجع هوش مصنوعی همین سایت است که هر ردیفش تاریخ خواندن و منبع دارد؛ چیزی که این درس به شما می دهد این است که وقتی آن جدول را می خوانید بدانید ستون مجوز یعنی چه.
یک مرز هم بگذاریم: تمام این بحث درباره مدل های زبانی است. مدل های تصویر و صدا مجوزهای متفاوت و گاهی سخت گیرتر دارند، و مدل هایی که خروجی شان مستقیم به دست مشتری می رسد سوال دیگری هم دارند که در درس های دیگر همین مسیر آمده: خروجی مدل، از نظر حقوقی، مال کیست.
مسیر سریع با هوش مصنوعی
مجوز خواندن کار وکیل نیست ولی کار حوصله می خواهد، و دقیقا همان جایی است که مدل ها خوب اند: متن بلند، ساختار تکراری، سوال مشخص. ولی یک شرط دارد که اگر رعایت نشود جواب بدتر از نخواندن است. مدل را از حافظه اش نپرسید؛ متن مجوز را خودتان جلویش بگذارید و بخواهید بند به بند نقل قول کند. برای این کار یک مدل سریع و ارزان کافی است، چون کار استخراج است و نه قضاوت.
- به صفحه مخزن روی هاگینگ فیس بروید و فایل LICENSE را باز کنید. اگر مخزن چنین فایلی ندارد، همین جا بایستید: مجوز نامعلوم یعنی جواب منفی.
- کل متن مجوز را کپی کنید و همراه دستور زیر بفرستید. حتما بگویید کارتان چیست، وگرنه جواب کلی می گیرید که به درد نمی خورد.
- هر بندی که مدل نقل قول کرد را در متن اصلی پیدا کنید. اگر نتوانستید پیدا کنید، آن بند وجود ندارد و بقیه جواب هم مشکوک است.
- خروجی را با تاریخ و آدرس مخزن در پرونده پروژه ذخیره کنید. نسخه بعد مدل مجوز دیگری خواهد داشت و آن روز باید بدانید امروز چه چیزی را قبول کرده اید.
نسخه آماده کپی
متن زیر فایل LICENSE یک مدل است. فقط از همین متن جواب بده و از دانسته های خودت درباره این مدل استفاده نکن.

کار من: {مثلا اجرای مدل روی سرور خودمان برای تولید متن سایت مشتری}
اندازه کسب و کار من: {مثلا هفت نفر، درآمد سالانه زیر یک میلیارد تومان}

برای هر مورد زیر، اول عین جمله مجوز را نقل قول کن و بعد در یک خط بگو برای کار من فعال می شود یا نه:
۱. آیا استفاده تجاری اجازه دارد
۲. آیا شرط درآمدی هست و عددش چند است
۳. آیا باید اسم مدل را جایی نشان بدهم
۴. آیا برای سرویس دادن به مشتری شرط جداگانه ای هست
۵. آیا خروجی مدل محدودیتی دارد

اگر متن درباره موردی حرفی نزده، بنویس «در این متن نیامده» و چیزی حدس نزن.

--- متن مجوز ---
{کل فایل LICENSE را اینجا بچسبانید}
قبل از اعتماد به خروجی: این دستور یک جواب حقوقی به شما نمی دهد و قرار هم نیست بدهد؛ کاری که می کند این است که پنج سوال درست را از یک متن بلند بیرون می کشد تا اگر جایی جدی بود بدانید چه چیزی را باید به آدم حقوقی نشان بدهید. دو قدم آخر را حذف نکنید: نقل قول ها را در متن اصلی پیدا کنید، و مدلی که برای هر پنج مورد بندی از خودش ساخته باشد را دور بیندازید و از اول شروع کنید.
هوش مصنوعی در این کار
برای این موضوع، ابزار اصلی یک چت بات نیست؛ خود کاتالوگ مخزن هاست. ولی دو کار هست که مدل ها واقعا در آن کمک می کنند: خواندن متن مجوز که در بخش بالا دیدید، و امتحان کردن خود همین مدل های متن باز برای اینکه بفهمید فاصله شان با مدل های درجه یک روی کار شما چقدر است. موضع ما صریح است: هیچ وقت از یک مدل نپرسید مجوز فلان مخزن چیست. آن اطلاعات وقتی آموزشش تمام شده وجود نداشته و جوابی که می گیرید با اطمینان کامل غلط خواهد بود.
ابزارهایی که واقعا کمک می کنند
- Hugging Face جایی که وزن ها و فایل مجوز واقعا زندگی می کنند. صفحه هر مخزن، فایل ها و تاریخ آخرین تغییرش را نشان می دهد و همین سه چیز کل بررسی این درس است.
- DeepSeek هم API دارد و هم وزن هایش روی حساب رسمی خودش با مجوز MIT هست، پس برای مقایسه دو مسیر مناسب ترین نمونه است. درباره دسترسی از ایران ادعایی نمی کنیم و در فایل خودمان هم ننوشته ایم.
- Kimi برای اینکه ببینید یک مجوز اختصاصی در عمل چه شکلی است، بهترین نمونه همین است: متنش کوتاه است، شرط هایش شماره دار است و در ده دقیقه خوانده می شود. مونشات فهرست کشورهای پشتیبانی شده منتشر نمی کند و ما هم چیزی درباره دسترسی ننوشته ایم.
- Claude وقتی متن مجوز را جلویش می گذارید و می خواهید بند به بند نقل قول کند، جواب های صریح تری می دهد و کمتر جای خالی را با اطمینان ساختگی پر می کند. ایران در هیچ کدام از دو فهرست کشورهای پشتیبانی شده انتروپیک نیست.
کجا نتیجه معکوس می دهد
خطر مشخص این موضوع، جواب مطمئن و غلط درباره مجوز است. هر مخزن مجوز خودش را جدا اعلام می کند، و راهنمای خود هاگینگ فیس هم همین را می گوید؛ ولی یک مدل زبانی وقتی می پرسید «مجوز فلان مدل چیست» از الگوی کلی چیزی که در آموزشش دیده جواب می سازد، و آن الگو معمولا از نسخه های قبلی همان خانواده می آید. برای همین درباره جیالام می گوید MIT، که برای ۵.۲ درست است و برای ۵.۳ نیست. خطر دوم بازنشرهای فشرده شده است: مخزنی که مجوز ثبت نکرده، مجوز مخزن اصلی را به ارث نمی برد، و اگر آن را در تحویل مشتری بگذارید مسئولیتش با شماست. خطر سوم به داده مربوط است: اگر متن مجوز یک قرارداد خصوصی باشد و آن را در یک چت بات بچسبانید، بسته به نوع حساب و تنظیمات ممکن است برای آموزش استفاده شود، و انتروپیک این را در صفحه حریم خصوصی اش توضیح داده. برای وضعیت دسترسی و پرداخت این ابزارها از ایران، راهنمای خرید را ببینید.
منبع ها: Hugging Face: licenses are declared per repository Hugging Face: what a model card contains Anthropic: is my data used for model training Anthropic: supported countries
حد این توصیه
هر چیزی که در این صفحه نوشته شده وضعیت ۶ سپتامبر ۲۰۲۶ است و پایدار نیست؛ همان مثال جیالام ۵.۲ و ۵.۳ نشان می دهد فاصله بین دو مجوز متفاوت می تواند یک نسخه باشد. دوم اینکه ما هیچ کدام از این مدل ها را روی سخت افزار خودمان اجرا نکرده ایم: اعداد پارامتر از مخزن سازنده است و درباره سرعت یا کیفیت اجرای محلی هیچ ادعایی نمی کنیم. سوم اینکه این درس مجوز را توضیح می دهد و مشاوره حقوقی نیست؛ اگر قراردادی روی این تصمیم بسته می شود، متن مجوز را به کسی نشان بدهید که کارش همین است. و چهارم اینکه بحث فقط درباره مدل های زبانی است و مدل های تصویر و صدا قاعده های خودشان را دارند.
از تجربه خود ما
خود ما دقیقا در همان تله ای افتادیم که این درس درباره اش است. برای بخش هوش مصنوعی این سایت ۱۱۰ فایل نسخه مدل نگه می داریم و ۱۳ تای آنها وزن باز ثبت شده اند: ۷ تا Apache 2.0، ۲ تا CC BY-NC 4.0، ۲ تا مجوز جامعه لاما ۴، یکی Modified MIT و یکی هم بدون مجوز ثبت شده. ولی ردیف deepseek-v4-pro در همان کاتالوگ ما open_weights را false ثبت کرده بود، چون منبعش صفحه قیمت گذاری دیپ سیک بود و صفحه قیمت گذاری درباره وزن ها حرفی نمی زند. روزی که این درس را می نوشتیم مخزن deepseek-ai/DeepSeek-V4-Pro-0813 با مجوز MIT و ۶۶ فایل safetensors روی هاگینگ فیس نشسته بود. یعنی فایل خودمان یک ماه غلط بود، و دقیقا به همان دلیلی که این صفحه هشدار می دهد: مجوز را از صفحه ای خوانده بودیم که جای مجوز نیست. این را در گزارش همین جلسه ثبت کرده ایم تا اصلاح شود.
سوال هایی که واقعا پرسیده می شوند
دیپ سیک متن باز است
وزن های مدل هایش روی حساب رسمی خودش با مجوز MIT منتشر شده اند، پس وزن باز است. ولی داده آموزش منتشر نشده، پس به معنای نرم افزاری کلمه متن باز نیست. و این جواب درباره همان مخزن هایی است که امروز آنجاست، نه درباره شرکت.
می توانم مدل متن باز را در پروژه مشتری استفاده کنم
در بیشتر موارد بله، چون شرط های درآمدی این مجوزها از ده ها میلیون دلار شروع می شوند. استثنای واقعی CC BY-NC است که استفاده تجاری را در هر اندازه ای ممنوع می کند. پس قاعده ساده این است: فایل LICENSE را باز کنید و دنبال عبارت non-commercial بگردید.
برای اجرای این مدل ها چه سخت افزاری لازم است
بستگی به تعداد پارامتر دارد و می توانید خودتان تخمین بزنید: در دقت ۱۶ بیتی هر پارامتر دو بایت است، پس مدل ۲۷.۸ میلیاردی حدود ۵۵ گیگابایت فقط برای وزن ها می خواهد. نسخه های فشرده جامعه این عدد را خیلی کم می کنند. ما هیچ کدام را روی سخت افزار خودمان اجرا نکرده ایم و عدد اندازه گیری شده ای نداریم.